
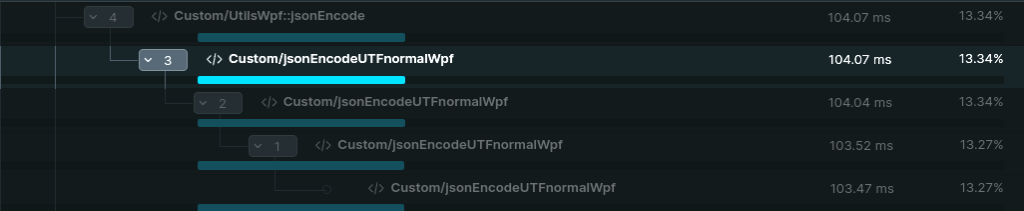
En stille eftermiddag i New Relic fik vi øje på noget, der ikke burde være der: en sidevisning af et kategoriarkiv i en WooCommerce-butik, hvor omkring 100 millisekunder gik med at lave JSON. Det lyder ikke af meget, men det er tid, der lægges oven i hver eneste visning af hver kategori, og JSON-kodning burde tage en brøkdel af det.
Synderen var en lille funktion i et populært filter-plugin til WooCommerce. Her er, hvordan vi fandt den, hvorfor den var skrevet, som den var, og hvordan et enkelt kald til PHP’s egen JSON-funktion gjorde den over hundrede gange hurtigere.
Sporet i New Relic
Tracen pegede på en funktion ved navn jsonEncodeUTFnormalWpf(). Den kaldte sig selv igen og igen, et kald for hver nøgle og hver værdi i de data, pluginet sendte med til filteret på siden, og hvert kald gik tegn for tegn igennem sin tekst. Det var ikke en enkelt langsom operation, men tusindvis af små.
Hvorfor koden så sådan ud
Navnet giver et fingerpeg. »UTFnormal« handler om tegnsæt, og den slags hjemmebyggede JSON-funktioner var ikke usædvanlige i PHP-kode fra midten af 00’erne. PHP fik først sin egen JSON-funktion i 2006, og de muligheder, der gør den brugbar til tekst med æ, ø og å og til data med fejl i, kom først i løbet af de følgende år:
| PHP-version | År | Det, der kom |
|---|---|---|
| 5.2.0 | 2006 | json_encode() |
| 5.4.0 | 2012 | JSON_UNESCAPED_UNICODE: tegn som æ skrives direkte i stedet for som \u00e6 |
| 5.5.0 | 2013 | JSON_PARTIAL_OUTPUT_ON_ERROR: én dårlig værdi får ikke hele resultatet til at fejle |
| 7.2 | 2017 | JSON_INVALID_UTF8_SUBSTITUTE: ugyldige tegn erstattes i stedet for at stoppe kodningen |
Skulle man i 2006 have pæn og fejltolerant JSON på tværs af de servere, WordPress kørte på, måtte man bygge den selv. Funktionen var altså ikke dårligt skrevet. Den løste et problem, der fandtes dengang, og den var blevet stående i mange år efter, at PHP selv havde løst det.
Hvad funktionen gjorde
Sådan håndterede den tekst:
function jsonEncodeUTFnormalWpf($value) {
    if (is_int($value)) {
       return (string) $value;
    } elseif (is_string($value)) {
       // erstat specialtegn
       $value = str_replace(array('\\', '/', '"', "\r", "\n", "\b", "\f", "\t"),
                       array('\\\\', '\/', '\"', '\r', '\n', '\b', '\f', '\t'), $value);
       // tegntabel, der aldrig bliver brugt
       $convmap = array(0x80, 0xFFFF, 0, 0xFFFF);
       $result = '';
       // byg teksten op igen, ét tegn ad gangen
       for ($i = strlen($value) - 1; $i >= 0; $i--) {
          $mb_char = substr($value, $i, 1);
          $result = $mb_char . $result;
       }
       return '"' . $result . '"';
    }
    // ... resten af funktionen
For hver tekst, også et kort ord som »product«, kørte den først en udskiftning af otte forskellige tegn. Så oprettede den en tegntabel, som aldrig blev brugt, sandsynligvis en rest af en ældre udgave. Til sidst gik den baglæns gennem teksten og byggede den op igen forfra, én byte ad gangen med substr(). Resultatet var præcis den samme tekst, men hvert skridt lavede en ny streng i hukommelsen.
Arrays fik deres egen tur. Før funktionen kunne kode et array, gennemløb den det for at finde ud af, om nøglerne var 0, 1, 2 og så videre (en JSON-liste) eller navne (et JSON-objekt):
} elseif (is_array($value)) {
       $with_keys = false;
       $n = count($value);
       for ($i = 0, reset($value); $i < $n; $i++, next($value)) {
          if (key($value) !== $i) {
             $with_keys = true;
             break;
          }
       }
Bagefter gennemløb den arrayet igen og kaldte sig selv for hver nøgle og hver værdi. For et objekt blev nøglen også sendt gennem hele tekstbehandlingen ovenfor.
Hvorfor det blev dyrt
Hver del for sig er billig. Problemet er, at de ganges med hinanden. Et filter på et kategoriarkiv kan have mange egenskaber og mange værdier, hver med navne, tællere og indstillinger, og alt sammen ligger i indlejrede arrays. For hvert niveau skal arrayet gennemløbes to gange, for hver nøgle og værdi er der et nyt funktionskald, og for hver tekst bliver der bygget en ny streng en byte ad gangen. PHP skal oprette og rydde op efter et stort antal små strenge undervejs.
Det er arbejde, som PHP’s indbyggede json_encode() klarer i C i ét gennemløb. Den gamle funktion gjorde det samme i PHP, med flere gennemløb og en masse mellemresultater, og det var her, de 100 millisekunder gik.
Løsningen
Da vi først forstod, hvad funktionen skulle kunne, var løsningen kort:
function jsonEncodeUTFnormalWpf($value) {
    return json_encode($value,
        JSON_UNESCAPED_UNICODE |           // æ, ø og å skrives direkte
        JSON_PARTIAL_OUTPUT_ON_ERROR |     // én dårlig værdi stopper ikke resten
        JSON_INVALID_UTF8_SUBSTITUTE       // ugyldige tegn erstattes
    ) ?: '';                               // tom streng ved fejl, som før
}
Funktionens navn og signatur er de samme, så resten af pluginet kalder den præcis som før. De tre flag genskaber det, den gamle kode forsøgte at opnå: læselig UTF-8, tolerance over for enkelte dårlige værdier og en sikker håndtering af ødelagte tegn. Og den tomme streng til sidst bevarer den gamle funktions opførsel, hvis kodningen fejler helt. I produktion faldt tiden fra omkring 100 ms til under 1 ms.
En ændring direkte i et plugins filer bliver overskrevet ved næste opdatering. Den holdbare løsning er at sende rettelsen til udvikleren og indtil da holde styr på, at den skal lægges på igen. Flere eksempler på den slags forbedringer finder du i vores guide om PHP-optimering.
Benchmark
Vi kunne ikke finde en trace af den nye funktion, der kunne sammenlignes direkte med den gamle, så vi skrev en lille benchmark, der kører begge udgaver på de samme testdata:
Legacy Implementation:
  Time: 0.993 ms
Modern Implementation:
  Time: 0.007 ms
Det er omkring 141 gange hurtigere (0,993 ms ÷ 0,007 ms). Tallene er fra testdata, ikke fra butikkens rigtige filterdata, derfor er de lavere end de 100 ms i produktion, men billedet er det samme. Koden til benchmarken ligger på GitHub.
Hvad vi tager med
Det første er, at man skal måle. Ingen ville have gættet på JSON-kodning som årsagen til et langsomt kategoriarkiv. Det krævede et APM-værktøj som New Relic, der viser, hvor tiden går i hver funktion. Det andet er, at de dyreste ting ofte er dem, ingen tænker over. En funktion, der gør noget så grundlæggende, bliver sjældent mistænkt, og den her havde sandsynligvis været langsom i årevis.
Det tredje er at spørge, om PHP selv kan det nu. Nogle plugins og temaer bærer rundt på løsninger på problemer, sproget har løst for længst. Og det fjerde: når gammel kode moderniseres, skal den holde sin aftale med resten af koden. Samme navn, samme input, samme output, så intet andet går i stykker.
Har din butik en funktion til 100 ms?
Den slags fund er en stor del af det, vi laver, når vi optimerer webshops. Læs mere om WordPress-performance generelt, eller om hvordan vi arbejder med performance-optimering af WooCommerce.